
エージェント時代のCPU路線争い:NVIDIAは「単一コアの高速化」に賭け、AMDは「より多くの並列処理」に賭ける

NVIDIAとAMDが競っているのは、単にどちらのCPUが速いかということではなく、AI時代のCPUの評価基準を誰が定義するかという点だ。
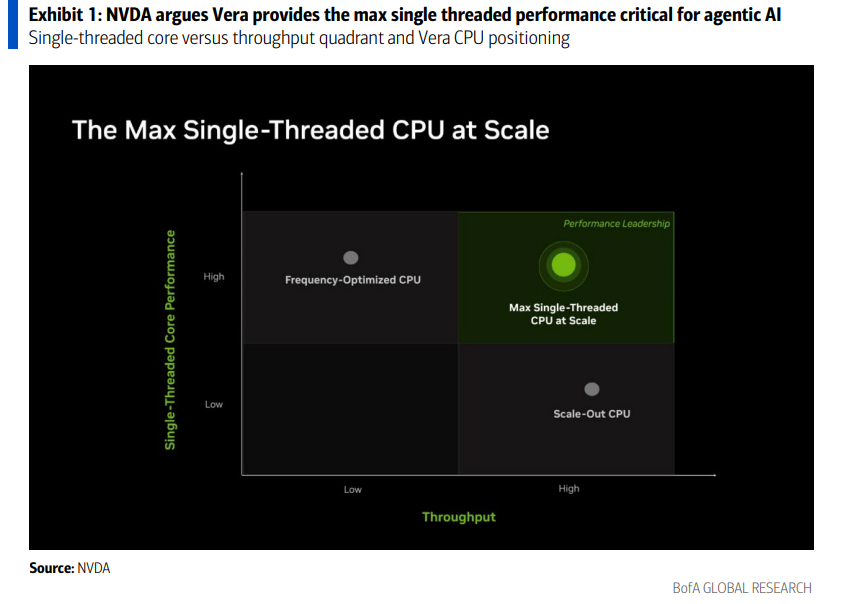
NVIDIAは最近、Vera CPUアーキテクチャの詳細な技術情報を公開した。このプロセッサは自社開発のOlympus ARMアーキテクチャコア88個を搭載し、メモリ帯域幅は1.2TB/s、オンチップインターコネクト帯域幅は3.4TB/sとなっている。NVIDIAの主張の核心は、AI Agentの動作はCPUとGPUが繰り返しかかわり合うことで成り立つ、つまりツール呼び出し、コード実行、データ検索、タスクオーケストレーションなどの各段階がすべて前のステップの完了に依存するため、CPUのシングルコア速度とレイテンシがエージェント全体の応答効率を直接決定するということだ。
7月23日、風を追うトレーディングデスクのニュースによると、Bank of America SecuritiesのアナリストVivek Aryaは最新のレポートで、Veraの発表が業界に新たな評価フレームワーク―「大規模化における最大シングルスレッド性能」―を持ち込んだと指摘。この考えはAMDが長年主張してきたチップレットによるマルチコアスタック路線とは直接対立するものであり、同アナリストはこの論争を「Agent型AIは単一タスクの完了時間で詰まるのか、それとも1つのラックで同時に処理できるタスク数で詰まるのか?」と位置付けている。AMDは今週木曜日にAI 2026テクノロジーデイを開催し、このフレームワークに公式に初めて応答する見込みだ。
この論争の背景には、サーバー向けCPU市場がAI需要によって再構築されつつあり、2030年には市場規模が現在の約4倍、1700億ドルに達すると予想されていることがある。これは既存規模のシェア争いではなく、新たに形成される成長市場だ。業界で認められるパフォーマンス評価基準を先に確立した者が、価格決定とナラティブの主導権を握る。
NVIDIAの論理:Agentの処理速度が重要、同時実行数よりも大事
NVIDIAによるAgentのワークフローの説明はきわめて具体的だ。Agentがタスクを進める過程で、CPUとGPUの間には大量の直列的なやり取りが発生し、各呼び出しは前の処理が終わって初めて継続できる。つまり、一つでもプロセスの遅延があるとその分レイテンシが蓄積・増幅され、最終的にAIファクトリー全体の生産効率が低下する。
このロジックにおいて、シングルコア性能は単なるスペック値ではなく、GPUのリソース活用率を左右する重要な変数となる——CPUが速ければ速いほど、GPUの待機時間は短くなり、システム全体のリソース利用効率は向上する。つまりコアが速いほど全体の応答速度が速くなる。
Veraにはもう一つ注目すべき設計ポイントがある。NVIDIAはチップレット分離アーキテクチャではなく単一計算ダイ(monolithic die)を選択したが、その理由は前者のほうが「スケーラブルな一貫性」を提供できるからだという。これはAMDが長年推進してきたチップレット路線とは対立しており、両社のアーキテクチャ哲学の根本的な対立が明確になったことを意味する。
さらにVeraは単体製品ではなく、NVIDIA全体のAIインフラエコシステムにおける「協調設計」の一部として、Rubin GPU、Groq LPX、Spectrumスイッチ、BlueFieldストレージ/ネットワークカードと連携して動作する。このシステム全体での統合こそ、NVIDIAが単一ハードウェア比較にとどまらない真の競争優位である。
AMDの反論:現実のAI生産現場では並列処理能力が勝負
AMDのスタンスは「現実の生産環境」の違った定義に基づいている。
AMDの視点では、本番AIシステムは一つのAgentが逐次処理するものではなく、データベース、API、ベクトルストア、オーケストレーションエンジン、キャッシュやミドルウェアなどで構成される分散型ソフトウェアプラットフォームに近い。このような環境では、ボトルネックは単一タスクの処理速度ではなく、一定の消費電力内で同時にどれだけ多くのワークフローを抱えられるかにある。
AMDは具体的な推計も示している。シミュレートされた100kWラック導入のシナリオでは、EPYC 9965(Turin)のラックレベルスループットはNVIDIA Vera基準の約2.4倍、次世代EPYC 6(Venice)は3.3倍に達すると見込まれる。
AMDの論理はこうだ:スループット密度が高いほど、同じ消費電力でより多くのユーザーにサービスでき、より多くのリクエストを処理できる——これこそクラウドAI導入の本当のコスト関数だ。
AMD x86かNVIDIA ARMか:ソフトウェアイコシステムが見えない主戦場
CPUアーキテクチャの争いは命令セットのレイヤーにも広がっている。
NVIDIAはARMアーキテクチャを選択し、「マイクロアーキテクチャが十分優れていれば、命令セットの互換性は二の次でも良い」と暗黙の立場を示している。しかしAMDとIntelは、今週の木曜日以降も「AIがモデル推論からエンタープライズソフトウェアワークフローへと拡大しつつある今、エンタープライズ向けソフトウェアはデータベース、ミドルウェア、セキュリティプラットフォーム、業務アプリケーションなどのレイヤーでx86系エコシステムによる数十年にわたる最適化と信頼性・互換性を蓄積してきた」という点を強調し続ける見通しだ。
これは単なる技術論争ではない。AIワークロードが次第に企業の既存ITシステムに組み込まれるにつれ、ソフトウェアエコシステムの歴史的蓄積は、ハードウェアのピーク性能以上に代替困難なものとなりうる。NVIDIAがVeraでこれらのシナリオに参入できるかどうかは、ARMのソフトウェアエコシステムの成熟速度に大きく左右されるだろう。
標準争い:次のCPU KPIは誰が決める?
2つのフレームワーク、2つのKPI、本質は両社が業界ナラティブの主導権をめぐって争っているということである。
NVIDIAのフレームワークはレイテンシ、シングルスレッド進捗、GPU利用率にフォーカスし、AMDのフレームワークは並列度、スループット、サービス密度を軸にしている。
ポイントは、市場が最終的にどの指標を使ってサーバー向けCPUを調達することになるかだ。
Bank of Americaの見方では、AMDの木曜日のイベントで最も重要なのはベンチマークデータで対抗相手を圧倒することではなく、自社の評価基準を業界に理解・納得させることだとしている。どちらのフレームワークがデータセンターバイヤーに受け入れられるかが、この1700億ドル規模市場で価格決定権を握る鍵となる。
NVIDIAに対してNVDAの「買い」格付けを維持し、目標株価は350ドル(現在価格207.29ドル)とした。
免責事項:本記事の内容はあくまでも筆者の意見を反映したものであり、いかなる立場においても当プラットフォームを代表するものではありません。また、本記事は投資判断の参考となることを目的としたものではありません。
こちらもいかがですか?
決算シーズンの裏側:ASML(ASML.US)が3,480億ドルの時価総額変動をリード
水曜日の取引開始前に、7大企業の決算によるボラティリティ予想が公表された。ASMLが348億ドルの潜在的な値動きで首位となり、Bank of AmericaやMorgan Stanleyなどがそれに続いた。オプション市場はすでにリスクを織り込んでいる。
ゴールドマン・サックス:ブラジル大統領選の第1回投票結果が「史上最も忙しい週」を引き起こし、海外投資家はボルソナロ勝利に賭ける
ゴールド取引注意:中東ミサイルがサウジアラムコを攻撃、金価格は米国CPIデータの試練を待つ
機関が供給体制の変化を明らかに:米国の制裁によりイランの海上原油輸出が「ゼロ」に、ロシアの輸出は前月比6%増
Vortexaのデータによると、イランの原油海上輸出は9月第2週以降ゼロに落ち込み、10月5日時点でも回復していません。洋上タンカーに滞留しているイラン原油の総量は約8300万バレルに減少し、そのうち約4300万バレルは米国の封鎖の影響でホルムズ海峡西側に閉じ込められており、搬出が困難な状況です。イランを除くと、湾岸地域の9月の原油流量は戦前レベルの81%以上まで回復しており、主にサウジアラビアの輸出回復によるものです。
暗号資産価格
もっと見る


